Raport widoczności w AI dla marek ubezpieczeniowych w Polsce. Które marki pojawiają się w odpowiedziach modeli?


Wybierając ubezpieczenie samochodu, mieszkania lub podróży, możemy poprosić model AI o porównanie towarzystw i wskazanie propozycji dopasowanych do naszych potrzeb. ChatGPT i Gemini podają nazwy marek wraz z uzasadnieniem, które może stać się punktem wyjścia do bliższego zapoznania się z daną ofertą. Dla ubezpieczycieli to szansa na dotarcie do klienta już na początku jego poszukiwań. Dlatego w tym raporcie sprawdzam, które marki pojawiają się w odpowiedziach AI, jak są przedstawiane i skąd modele czerpią informacje na ich temat.
Spis treści:
- Widoczność marek ubezpieczeniowych w AI search wg Visibility Score
- Mention Rate i średnia pozycja. Jak często i jak wysoko pojawiają się marki?
- Ubezpieczenia w AI search. Z jakich źródeł korzystają modele?
- Analiza sentymentu. Jak modele przedstawiają ubezpieczycieli?
- Metodologia
- Podsumowanie
Widoczność marek ubezpieczeniowych w AI search wg Visibility Score
Porównanie zaczynam od analizy Visibility Score, czyli metryki łączącej częstotliwość obecności marki z jej pozycją w odpowiedziach. Zestawienie pozwala sprawdzić, czy wysoka widoczność ubezpieczyciela dotyczy kilku narzędzi, czy skupia się w wybranych systemach.
Dane Surfer AI Tracker pochodzą z drugiego tygodnia września 2026 r. i obejmują Google AI Mode, Google AI Overviews, Gemini, ChatGPT oraz Perplexity. To obraz badanego okresu i zestawu pytań, nie pomiar zmiany w czasie ani wszystkich potrzeb klientów.Raport dotyczy widoczności nazw marek, a nie jakości polis, składek ani warunków OWU.
Marka
AI Mode
AI Overviews
Gemini
ChatGPT
Perplexity
Wynik łączny
PZU
81
55
77
73
54
71
Allianz
75
56
72
76
75
71
Generali
63
59
71
68
82
68
Warta
67
45
72
79
71
67
ERGO Hestia
71
38
81
66
65
65
UNIQA
49
42
69
57
57
56
LINK4
36
32
42
35
55
38
InterRisk
48
39
32
14
-
35
AXA Polska*
34
-
41
-
28
31
Proama
30
21
33
22
35
29
Dane: Surfer AI Tracker, drugi tydzień września 2026. Wynik łączny to wartość All z narzędzia, nie średnia arytmetyczna pięciu kolumn. Znak „-” oznacza brak odnotowanej obecności w badanej próbie. AXA Polska* to etykieta z zestawienia, której zakres wymaga odrębnej interpretacji opisanej w metodologii.
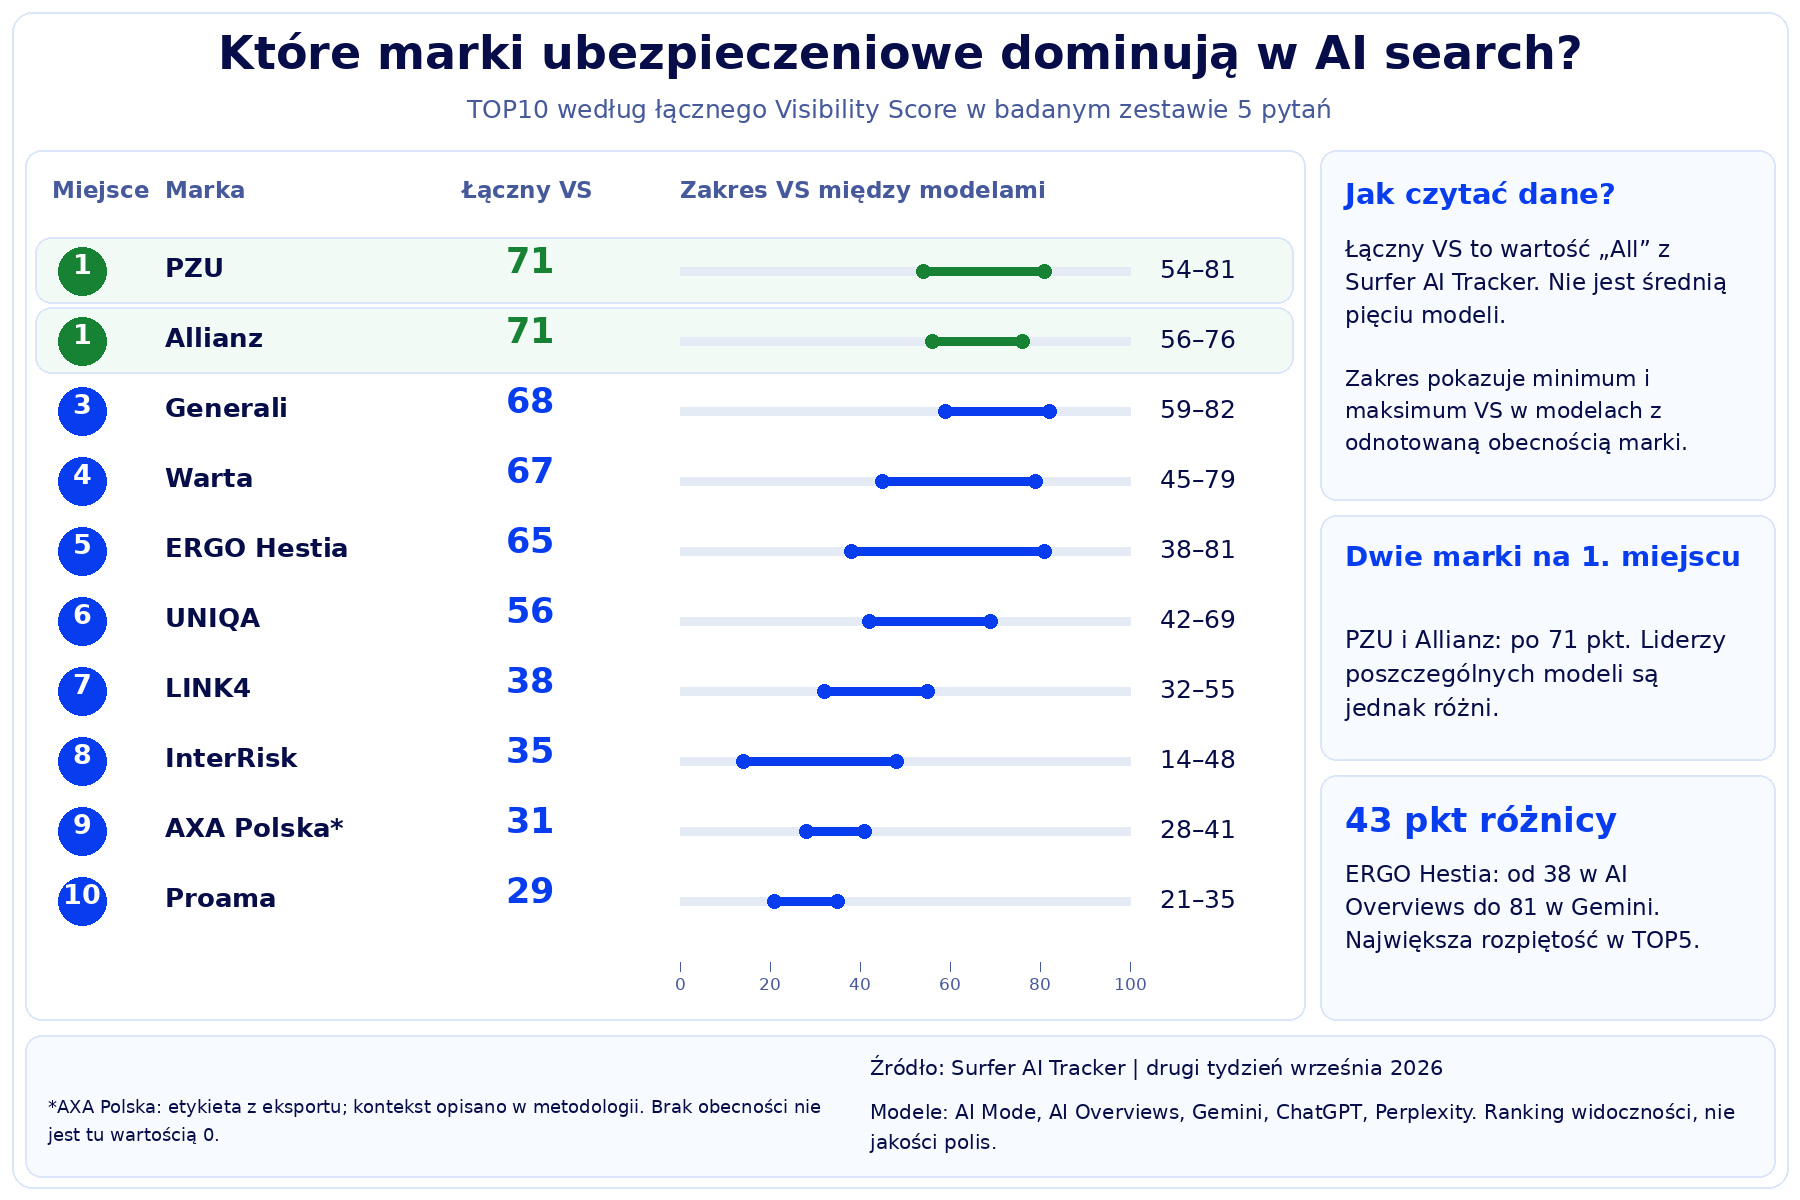
Widoczność marek ubezpieczeniowych według łącznego VS
Niejednoznaczny remis PZU i Allianz
PZU i Allianz zajmują pierwsze miejsce ex aequo z wynikiem łącznym 71 pkt, ale ich widoczność jest różna w poszczególnych modelach. PZU wyprzedza Allianz w AI Mode i Gemini, a w ChatGPT, AI Overviews i Perplexity kolejność się odwraca. Największa różnica występuje w Perplexity, gdzie Allianz ma 75 pkt, a PZU 54. Monitoring jednego systemu pokazałby więc ich wzajemną pozycję inaczej niż wynik łączny.
Allianz ma najmniejszą rozpiętość VS w pierwszej piątce. W czterech modelach jego wynik mieści się między 72 a 76 pkt. Jednym z możliwych wyjaśnień jest szeroka obecność marki w treściach własnych i zewnętrznych, dzięki której różne modele mogą znajdować informacje o jej ofercie. To hipoteza wymagająca sprawdzenia cytowanych materiałów, ale też wskazówka dla strategii SEO AI, że warto rozwijać obecność w różnych źródłach, dobranych na podstawie analizy branżowej.
Największą rozpiętość VS wśród marek z pierwszej piątki ma ERGO Hestia, której najlepszy i najgorszy wynik dzieli 43 pkt. Zróżnicowany profil ma również Warta, dla której rozpiętość między modelami wynosi 34 pkt.
Dlaczego niższy wynik nie zawsze oznacza słabą pozycję?
Cztery z pięciu czołowych marek swój najniższy VS notują w AI Overviews, ale mimo tego jedna z nich - Generali - jest liderem zestawienia dla tego modelu. Jego 59 pkt nie należy więc nazywać słabą pozycją tylko dlatego, że w Perplexity osiąga 82 pkt. Ocena widoczności zawsze powinna być uzależniona od punktu odniesienia, co ten przykład doskonale pokazuje.
W Perplexity swoje najwyższe wyniki osiąga nie tylko Generali, ale też LINK4 i Proama. Ten model ma też mniejszą próbę odpowiedzi niż pozostałe systemy, dlatego jego wyniki warto traktować jako wskazanie do dalszej obserwacji, a nie dowód przewagi konkretnych marek.
Odpowiedzi bez podania marki – czemu warto ich szukać?
Znaczenie ma również to, czy przy danym pytaniu model w ogóle wymienia ubezpieczycieli. W AI Overviews przy pytaniu o likwidację szkód komunikacyjnych dane z AI Trackera nie zawierają żadnej wykrytej nazwy marki. Taka odpowiedź warto potraktować jako pretekst do sprawdzenia, czy cytowane materiały wskazują pytania, na które marka mogłaby odpowiedzieć we własnych treściach.
Co oznacza brak marki w jednym z modeli?
InterRisk nie ma odnotowanej obecności w Perplexity, a AXA Polska - w AI Overviews i ChatGPT. Brak w badanej próbie nie oznacza, że model nigdy nie wymienia danej nazwy. Zestaw pytań obejmuje kilka rodzajów ubezpieczeń, ale nie pokrywa wszystkich produktów oraz intencji klientów.
Aby dokładniej przyjrzeć się obecności marek, zestawiam Mention Rate ze średnią pozycją. Pierwszy wskaźnik pokazuje, jak często ubezpieczyciel trafia do odpowiedzi, a drugi - jak wysoko jest wymieniany. Oba mierniki przedstawiam w tabeli:Mention Rate i średnia pozycja. Jak często i jak wysoko pojawiają się marki?
Marka
AI Mode MR%
AI Mode Poz.
AI Overviews MR%
AI Overviews Poz.
Gemini MR%
Gemini Poz.
ChatGPT MR%
ChatGPT Poz.
Perplexity MR%
Perplexity Poz.
PZU
77
2
40
1.7
71
2
71
3
42
2.6
Allianz
77
3.7
49
3.2
74
4.5
77
3.4
75
3.4
Generali
60
3.7
51
2.9
69
3.6
71
4.6
83
3
Warta
60
2.4
29
2.4
66
2.6
74
1.9
67
3
ERGO Hestia
69
3.1
23
3.1
80
3
60
2.8
58
2.9
UNIQA
46
4.9
34
4.3
71
4.9
60
5.4
58
5.6
LINK4
23
4
14
3.2
29
3.9
34
6.6
58
6.4
InterRisk
40
4
20
2.4
23
6.3
9
7.7
-
-
AXA Polska
17
3.5
-
-
17
1.5
-
-
17
5.5
Proama
17
4.7
9
5
17
4.3
11
5.8
25
5.3
MR% = Mention Rate (odsetek odpowiedzi ze wzmianką marki). Poz. = średnia pozycja wzmianki w odpowiedzi (1 = pierwsza wymieniona).
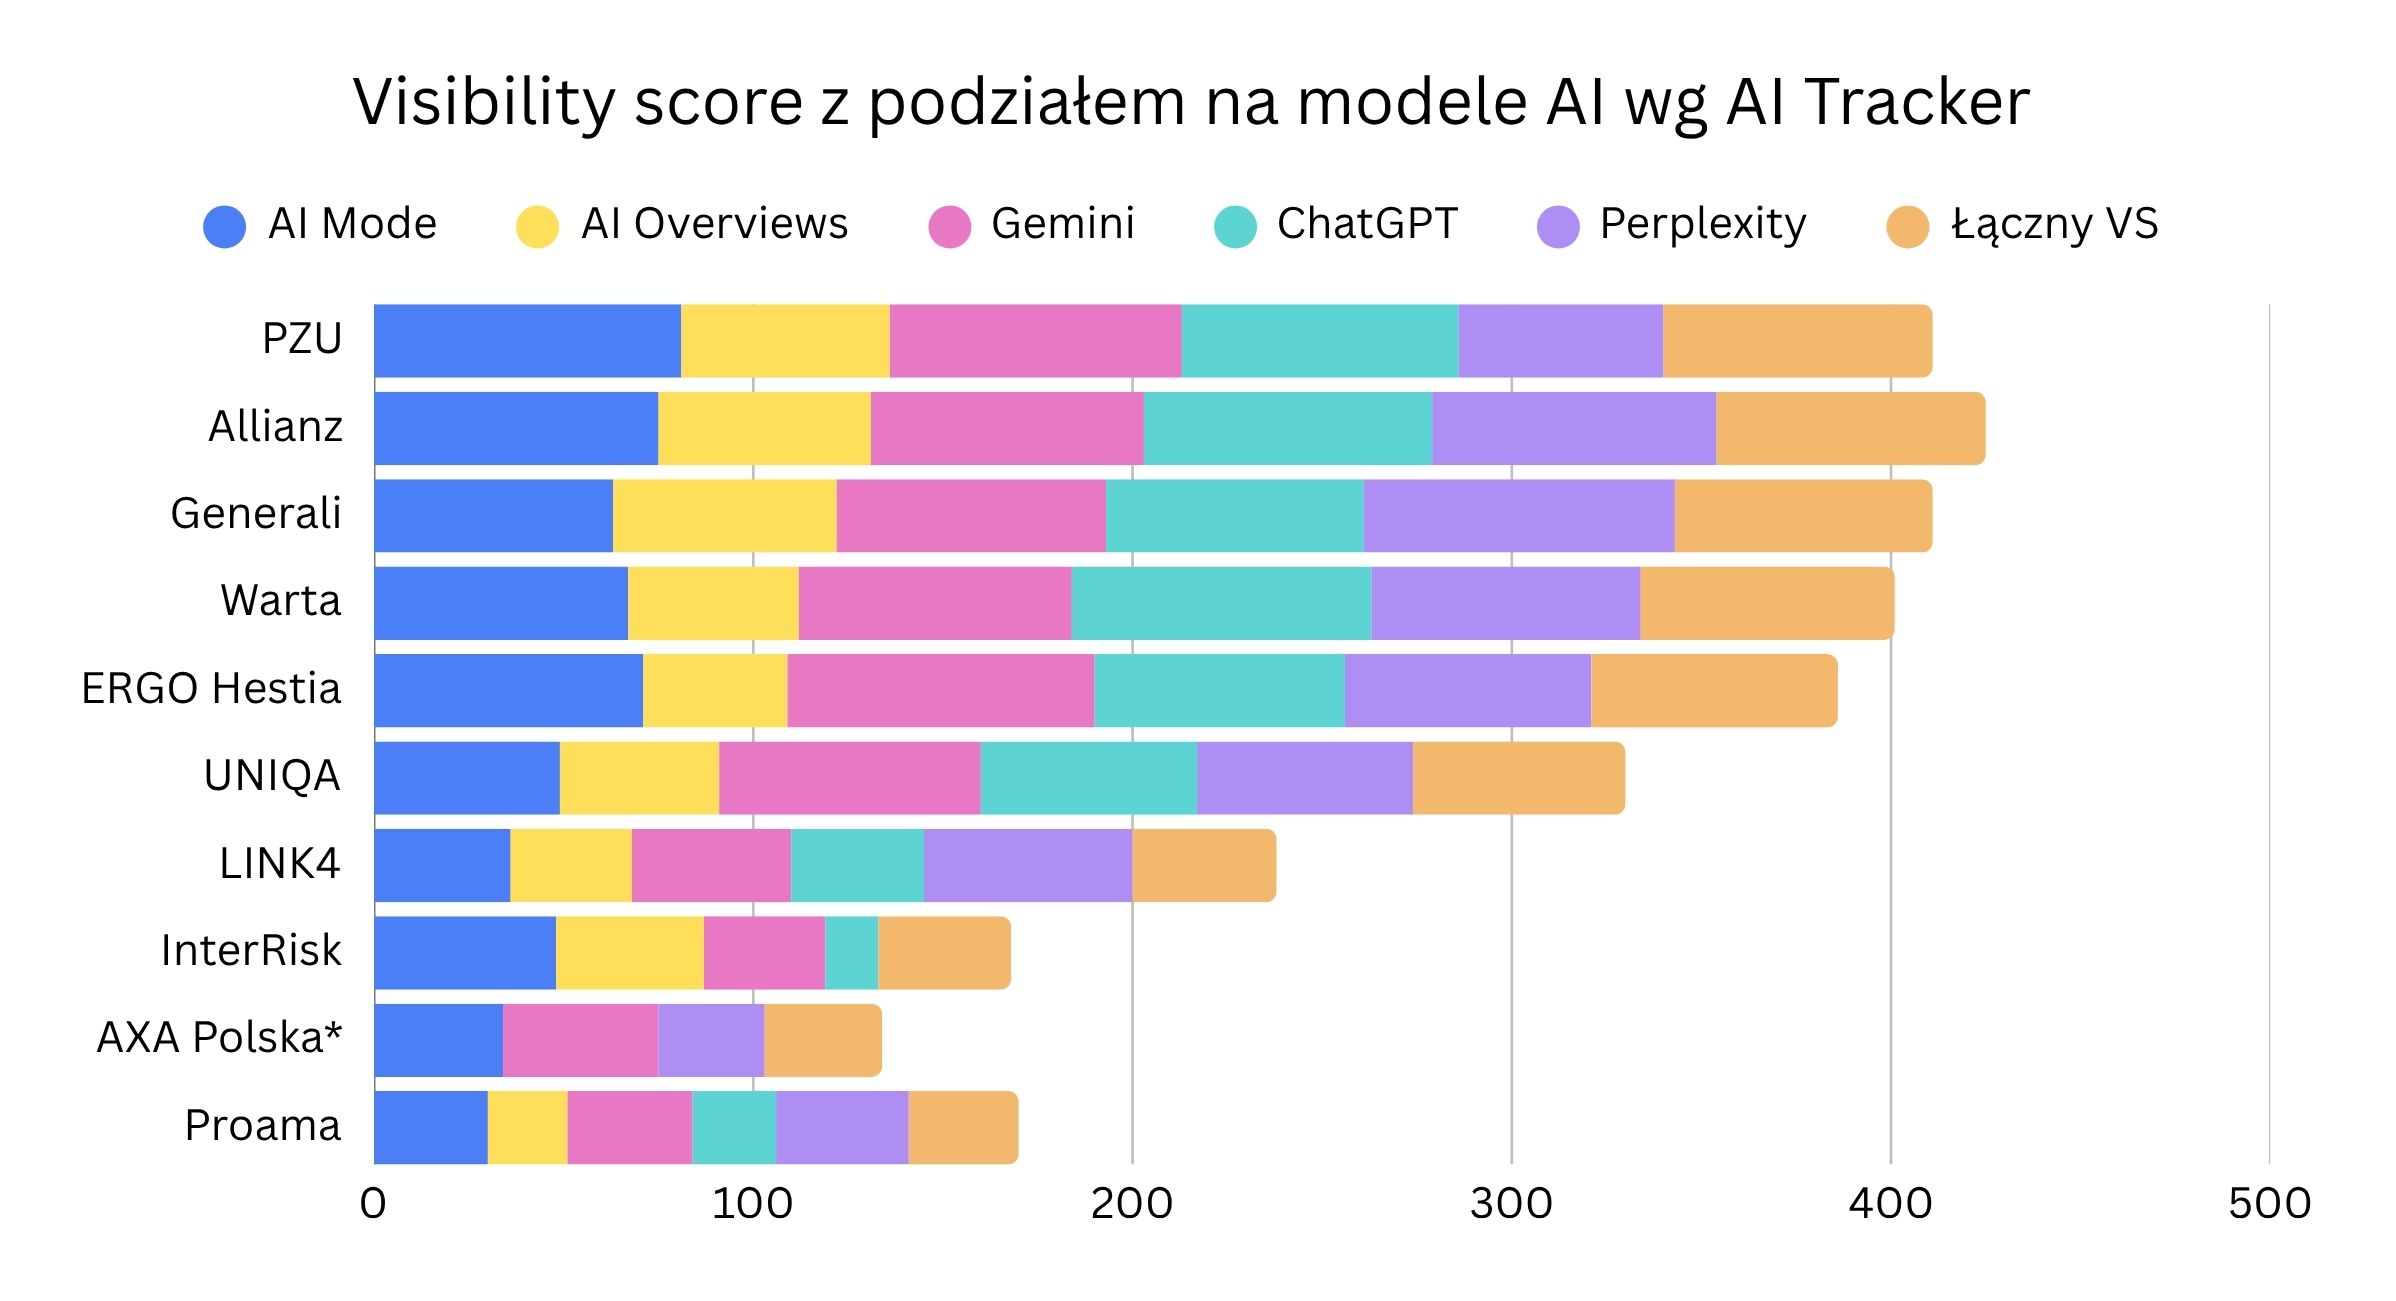
Najlepiej widoczne w AI search marki ubezpieczeniowe
Częściej nie znaczy wcześniej. Co pokazują PZU i Allianz?
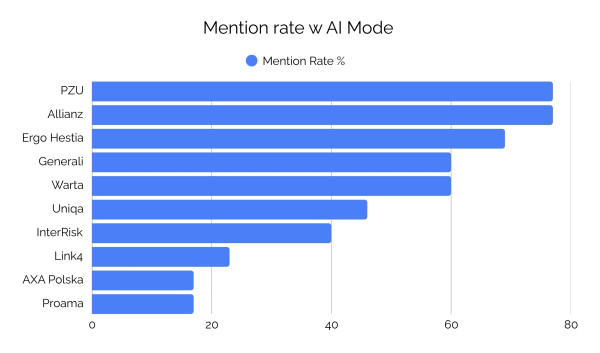
W AI Mode PZU i Allianz mają taki sam MR: 77%. Różni je jednak średnia pozycja, wynosząca odpowiednio 2,0 i 3,7. Podobna częstotliwość obecności może więc współistnieć z inną kolejnością wymieniania marek. Analiza treści odpowiedzi pozwoliłaby dodatkowo sprawdzić, jak model przedstawia wcześniej wymienione marki i czym uzasadnia ich wybór.
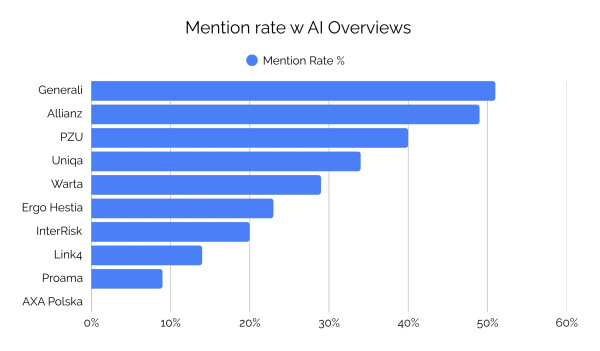
W AI Overviews sytuacja jest inna. PZU pojawia się rzadziej niż Allianz, ale nadal ma lepszą średnią pozycję. Jego MR wynosi 40%, a średnia pozycja 1,7. Dla Allianz jest to 49% i 3,2. PZU zajmuje zatem wysokie miejsca w odpowiedziach, do których trafia, lecz pozostaje nieobecne w większej części próby. Średnia 1,7 nie oznacza jednak, że PZU w każdej odpowiedzi zajmuje pierwsze lub drugie miejsce.
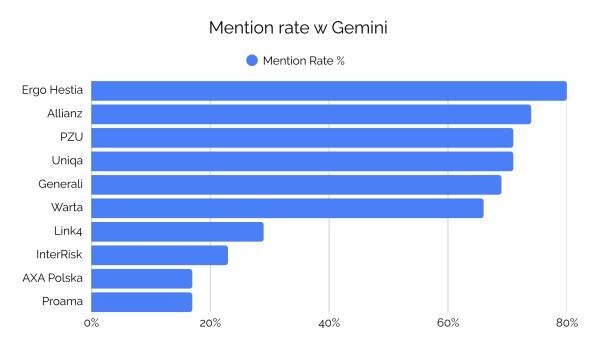
Najlepszą średnią pozycję w czołowej dziesiątce ma AXA Polska w Gemini - 1,5 przy MR 17%. Wysokie miejsce może więc łączyć się z rzadką obecnością. W tym przypadku trzeba również przeanalizować sentyment i upewnić się, czy wzmianki nie są związane ze ścisłym przypisaniem brandu do konkretnej niszy lub intencji.
Kiedy częsta obecność idzie w parze z wysoką pozycją?
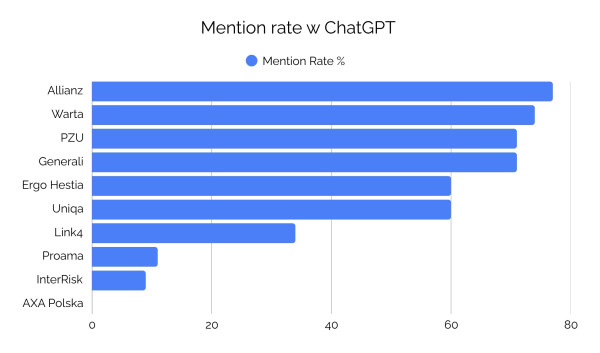
Warta w ChatGPT łączy MR 74% ze średnią pozycją 1,9. Allianz pojawia się nieco częściej, ale ma dalszą średnią pozycję, a PZU jest wymieniane rzadziej i również później. Przewaga Warty w VS tego modelu jest więc efektem częstego wymieniania marki na wysokich pozycjach. Nie oznacza to jednak, że każda wzmianka jest rekomendacją ani że marka zawsze otwiera listę.
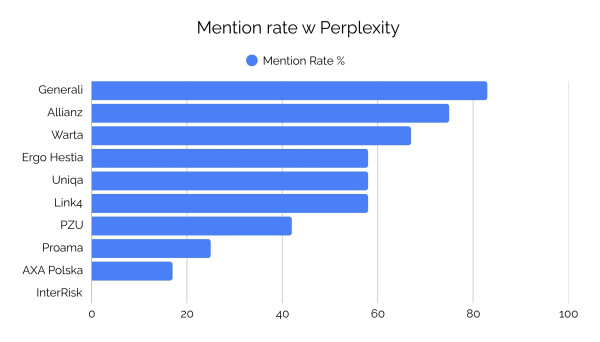
Inny profil ma LINK4 w Perplexity. Jego MR 58% jest taki sam jak ERGO Hestii i UNIQA, ale średnia pozycja 6,4 jest dalsza niż wspomnianej konkurencji (odpowiednio 2,9 i 5,6). Monitoring widoczności w AI search powinien więc sprawdzać nie tylko, czy firma została uwzględniona, ale też jak model przedstawia ją na tle pozostałych propozycji.
Przy niskim MR warto przeanalizować pytania, przy których model pomija markę. Przy częstych wzmiankach i dalszej pozycji warto sprawdzić argumenty towarzyszące wcześniejszym propozycjom. Wskaźniki pomagają wybrać odpowiedzi do analizy, ale same nie wyjaśniają przyczyny różnicy i nie mówią jednoznacznie, jak modyfikować strategię SEO AI.
Wynik procentowy to nie wszystko. Jak analizować widoczność w AI?
Generali osiąga w Perplexity najwyższy MR w tabeli, czyli 83% przy średniej pozycji 3,0. W tym pomiarze oznacza to obecność w 10 z 12 odpowiedzi. Jedna odpowiedź stanowi tu około 8,3 punktu procentowego, podczas gdy w próbach liczących po 35 odpowiedzi jest to około 2,9 punktu. Mały wolumen danych sprawia więc, że na wynik w Perplexity w tym raporcie może wpłynąć nawet pojedyncza odpowiedź.
W analizie widoczności ważne jest również to, z jakich materiałów modele korzystają przy opisywaniu ubezpieczycieli. Dlatego sprawdziłem najczęściej cytowane domeny. Ich zestawienie pomaga ustalić, gdzie szukać informacji współtworzących obraz marki w odpowiedziach AI.
Dane: Surfer AI Tracker, drugi tydzień września 2026. Liczba oznacza sumę Times shown dla adresów z danej domeny, bez ograniczenia do wierszy Mentioned = yes. Tabela prezentuje czołowe domeny z tego zestawienia, a nie pełną listę źródeł.
Wspólne źródło, różne listy ubezpieczycieli
Wśród domen cytowanych przez wszystkie pięć modeli prowadzi Rankomat. W ChatGPT pierwsze miejsce dzieli ponadto z warta.pl i otomoto.pl. Mimo wspólnego dla wszystkich analizowanych systemów źródła, liderzy zestawienia VS są różni.
Zestawienia VS dla poszczególnych modeli otwierają PZU w AI Mode, Generali w AI Overviews i Perplexity, ERGO Hestia w Gemini oraz Warta w ChatGPT. Wiedząc, skąd pochodzą informacje, nie wiemy nadal, co wpłynęło na kolejność marek w listingach. Aby się tego dowiedzieć, trzeba sprawdzić cytowane podstrony i powiązać je z konkretnymi pytaniami.
AI Overviews często przywołuje również mubi.pl, cuk.pl i uniqa.pl, zaś w czołówce Gemini są kalkulator-oc-ac.auto.pl, ranking-oc-ac.pl i departamentodszkodowan.pl. W ChatGPT obok porównywarki i portalu motoryzacyjnego pojawiają się strony własne Warty oraz Generali.
Rankomat.pl – co mówi silna obecność w źródłach?
Rankomat.pl pojawia się w źródłach wszystkich pięciu modeli, a najczęściej cytowaną podstroną tej domeny jest ranking OC, odnotowany w eksporcie łącznie 41 razy. Materiał porównuje ubezpieczycieli według konkretnych kryteriów. Uwzględnia likwidację szkód, jakość kontaktu i atrakcyjność oferty, a dane o skargach przedstawia w odniesieniu do udziału towarzystwa w rynku.
Taki materiał dostarcza zarówno nazw firm, jak i argumentów przydatnych do uzasadnienia wyboru. Z punktu widzenia analizy widoczności w Ai search i w kontekście różnic między modelami to wskazówka, by sprawdzać nie tylko obecność marki w porównywarkach. Ważne jest również to, na podstawie jakich informacji jej oferta jest oceniana i z jakimi potrzebami klientów zostaje powiązana.
Czy cytowanie własnej strony oznacza przewagę marki?
Warta.pl ma w ChatGPT 11 wystąpień, a więc tyle samo co rankomat.pl i otomoto.pl. Jednocześnie Warta osiąga w tym modelu najwyższy VS w badanej dziesiątce. Obie obserwacje są istotne, ale ich współwystępowanie nie dowodzi, że cytowania własnej witryny spowodowały dobry wynik marki. Wśród czołowych źródeł ChatGPT znajduje się też generali.pl, więc Warta nie jest jedynym ubezpieczycielem reprezentowanym w liście źródeł przez własną domenę.
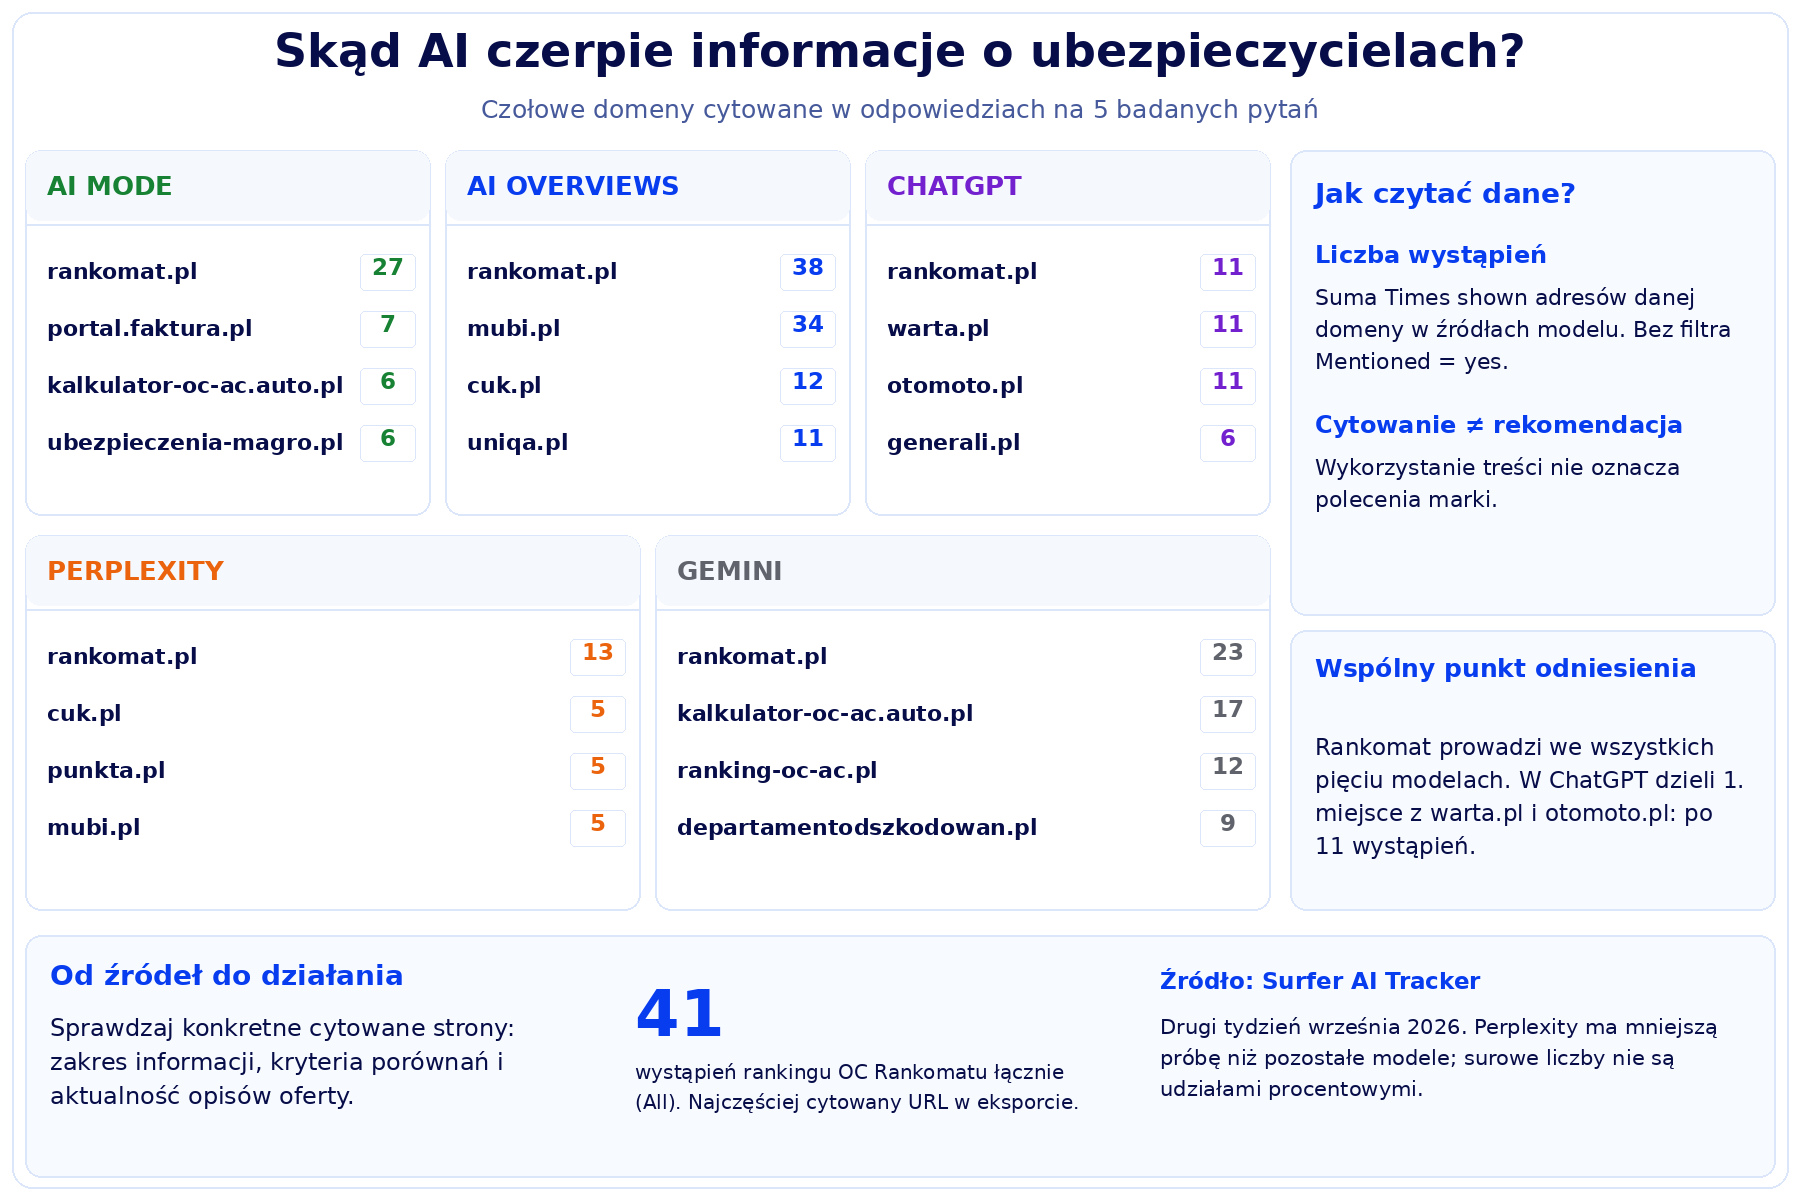
Czołowe domeny cytowane w pięciu modelach, z uwzględnieniem remisu w ChatGPT.
Analiza sentymentu. Jak modele przedstawiają ubezpieczycieli?
Same dane ilościowe nie pokazują, co modele piszą o ubezpieczycielach ani jak uzasadniają ich wybór. Dlatego monitoring uzupełniam jakościową analizą sentymentu. Przyglądam się argumentom rekomendacji, zastrzeżeniom oraz potrzebom klientów, z którymi modele wiążą poszczególne marki.
Badanie sentymentu opiera się na osobnych rozmowach obejmujących pięć pytań bazowych i bezpośrednie porównania marek. Wyniki mieszczą się między +0,76 a +0,92, więc dla wszystkich sześciu analizowanych marek są dodatnie. Scoring uzupełniam opisem argumentów, które modele przywołują przy rekomendacjach.
Źródło: analiza rozmów z ChatGPT i Gemini. Scoring sentymentu: od −1,00 (wyłącznie negatywny kontekst) do +1,00 (wyłącznie pozytywny kontekst). Marki uporządkowano malejąco według wyniku. Opisy są parafrazami, nie dosłownymi cytatami ani oceną jakości produktów.
Obsługa szkody czy szeroka dostępność? Rekomendacja zależy od kryterium
Porównanie Warty z PZU pokazuje różnicę między oceną ogólną a dopasowaniem do potrzeb. Według opisu rozmowy Gemini nie wskazało jednej marki jako lepszej we wszystkim. PZU wiązało ze skalą i dostępnością, a Wartę z obsługą i elastycznością. Model może więc pozytywnie przedstawiać obu konkurentów, ale uzasadniać wybór każdego z nich inną potrzebą klienta.
Allianz kojarzono z zakresem ochrony i wysokimi limitami, ERGO Hestię z obsługą cyfrową, a Generali z elastycznością produktów mieszkaniowych i ofertą dla firm. Dla zespołu marketingowego istotne jest sprawdzenie, czy te skojarzenia odpowiadają obszarom, które chce rozwijać. Pozytywny ton nie rozstrzyga, czy obraz marki jest kompletny i zgodny z aktualną strategią.
Zastrzeżenia i różnice w sposobie przedstawiania marek mogą wskazywać konkretne kierunki pracy nad treściami. Gemini opisuje procedury PZU przy skomplikowanych szkodach jako zbiurokratyzowane. Dla marki to powód, by sprawdzić, czy materiały dotyczące zgłaszania szkód jasno wyjaśniają kolejne etapy, wymagane dokumenty i możliwości odwołania od decyzji. Inny przykład dotyczy Allianz: Gemini przedstawia go jako markę premium, często droższą, podczas gdy ChatGPT przy ubezpieczeniu mieszkania zwraca uwagę na konkurencyjną cenę. Warto więc analizować skojarzenia cenowe osobno dla poszczególnych produktów i sprawdzać, czy treści pokazują konkretne warianty, zakres ochrony oraz założenia kalkulacji. Takie obserwacje pomagają wybrać materiały do weryfikacji i rozbudowy, choć same nie dowodzą, że przyczyną opinii modelu są braki w komunikacji.
Czy marka spoza TOP10 może otrzymywać pozytywne rekomendacje?
W badaniu sentymentu pojawiła się marka nieobecna w TOP 10 analizy ilościowej - mtu24. Brak w dziesiątce zestawienia łącznego VS nie oznacza jednak braku wzmianek ani pozytywnego kontekstu. Chociaż w rozmowie brand był pominięty przez ChatGPT, Gemini przywoływał go kilkakrotnie.
Stosunkowo wysoki scoring sentymentu mtu24 pokazuje, dlaczego warto wyjść poza pierwszą dziesiątkę rankingu. Marka o niższej ogólnej widoczności może otrzymywać pozytywne rekomendacje przy pytaniach dotyczących swojej specjalizacji.
Metodologia
Raport łączy monitoring widoczności w Surfer AI Tracker z analizą sentymentu na podstawie własnych rozmów z ChatGPT i Gemini. Poniżej wyjaśniam zakres obu części, sposób odczytywania danych i ograniczenia porównań.
Zakres monitoringu i dobór marek
Monitoring obejmował pięć promptów dotyczących OC i AC, likwidacji szkód, ubezpieczeń dla małych firm, mieszkań oraz podróży. Liczba zarejestrowanych odpowiedzi wynosiła po 35 dla czterech pierwszych systemów oraz 12 dla Perplexity, łącznie 152. Pięć promptów oznacza więc pięć tematów pomiaru, a nie tylko pięć odpowiedzi z każdego modelu. Mniejsza próba Perplexity ogranicza porównywalność odsetków i surowych liczb cytowań.
W tabelach VS, MR i pozycji zachowałem dziesięć nazw z głównego zestawienia, uporządkowanych według wyniku All. PZU i Allianz mają po 71 pkt i zajmują pierwsze miejsce ex aequo. Nie uwzględniam porównywarek, kalkulatorów ani EKUZ, ponieważ nie są markami ubezpieczycieli. Wyniki odnoszą się do nazw wykrytych w odpowiedziach. Nie konsoliduję ich automatycznie do grup kapitałowych.
Pozycję AXA Polska zachowuję z gwiazdką jako etykietę występującą w danych. Spółki AXA objęte połączeniem z UNIQA działają pod marką UNIQA od 9 kwietnia 2021 r. Jednocześnie AXA Partners oferuje ubezpieczenia turystyczne. Bez sprawdzenia każdej odpowiedzi nie można przypisać wszystkich wzmianek AXA jednemu z tych kontekstów ani po prostu doliczyć ich do UNIQA.
Jak odczytywać wskaźniki i źródła?
Visibility Score (VS) łączy częstotliwość obecności marki z jej pozycją w odpowiedziach. Wynik łączny to wartość All z narzędzia, a nie średnia arytmetyczna pięciu modeli. Wyników VS nie sumuję - służą do porównań w obrębie przyjętego zestawu pytań i sposobu pomiaru.
Mention Rate (MR) to odsetek odpowiedzi zawierających markę. Średnia pozycja dotyczy odpowiedzi z jej obecnością. Nie określa jednak skrajnych miejsc ani wydźwięku wzmianki. Znak „-” oznacza brak odnotowanej obecności w tej próbie, nie brak marki we wszystkich możliwych odpowiedziach modelu.
Jak przeprowadziłem analizę sentymentu?
Analiza sentymentu objęła 18 odpowiedzi - po pięć odpowiedzi na pytania bazowe i cztery porównania marek w każdym modelu. Zestawiłem w nich markę najczęściej wymienianą w danej rozmowie z brandami z miejsc 2-5. W Gemini punktem odniesienia była Warta, a w ChatGPT ERGO Hestia. ChatGPT zachował kontekst ostatniego pytania bazowego i wszystkie cztery porównania odniósł do ubezpieczeń turystycznych. Gemini porównywało marki szerzej, uwzględniając różne rodzaje polis.
P1–P5: pytania bazowe monitoringu i rozmów jakościowych. K1–K8: pytania porównawcze. ✓ oznacza pytanie zadane w danym modelu; - pytanie niezadane. Numeracja nie odzwierciedla kolejności pytań w rozmowach.
Scoring sentymentu opisuje wydźwięk wypowiedzi o marce w analizowanych rozmowach na skali od −1 do +1, gdzie pierwszy wynik oznaczałby same negatywne wzmianki, a drugi - wyłącznie pozytywne.
Podsumowanie
Zebrane dane pozwalają wskazać aspekty szczególnie ważne przy analizie własnej marki i planowaniu działań SEO AI w branży ubezpieczeniowej.
Co raport mówi o widoczności marek ubezpieczeniowych?
Wspólny ranking nie zastępuje analizy poszczególnych modeli i rodzajów pytań. PZU i Allianz mają ten sam wynik łączny, ale liderzy zmieniają się między systemami. Podobnie częste wzmianki mogą łączyć się z różnymi pozycjami, a pozytywny opis marki może dotyczyć tylko wybranego produktu. Dla zespołu marketingowego najważniejsze jest połączenie tych perspektyw przy pytaniach istotnych dla własnego biznesu.
Jak zbudować widoczność w AI? Praktyczne wskazówki
Ten raport wskazuje potrzebę uporządkowania pracy przede wszystkim w trzech obszarach:
- Monitoruj modele i kategorie produktów osobno. Sprawdzaj, czy marka pojawia się przy pytaniach dotyczących jej oferty, jak często i na jakich pozycjach. W kolejnych pomiarach zachowuj zestaw pytań oraz porównywalną liczbę odpowiedzi; szczególnie ostrożnie oceniaj zmiany przy małych próbach.
- Weryfikuj konkretne źródła opisów marki. Przy ważnych pytaniach łącz odpowiedź z cytowanym adresem. Sprawdzaj aktualność informacji we własnej witrynie, porównywarkach i pozostałych serwisach. Kontroluj również, czy model prawidłowo rozróżnia marki, nazwy historyczne i podmioty z tej samej grupy.
- Analizuj argumenty rekomendacji i zastrzeżenia. Ustal, czy AI kojarzy Twoją firmę z właściwymi produktami i potrzebami klientów. Przy danych o skargach, limitach lub zakresie ochrony sprawdzaj źródło i kontekst, zamiast traktować każdą wypowiedź modelu jako potwierdzony fakt o jakości usług.
Widoczność marek ubezpieczeniowych w AI - najważniejsze wnioski
- PZU i Allianz prowadzą ex aequo w wyniku łącznym, ale nie we wszystkich modelach. Osobne zestawienia otwierają PZU, Warta, ERGO Hestia i Generali. Pozycję wobec konkurencji w każdym systemie trzeba więc ocenić oddzielnie.
- Niższy wynik między modelami nie musi oznaczać słabej pozycji względem konkurentów. Generali ma w AI Overviews swój najniższy VS, a mimo to prowadzi w tym zestawieniu. Ważny jest zarówno wynik marki, jak i wyniki pozostałych firm w tym samym narzędziu.
- Częstotliwość i pozycja pokazują różne aspekty obecności. W AI Mode PZU i Allianz mają identyczny MR, lecz różne średnie pozycje. Sam odsetek wzmianek nie wystarcza do opisania sposobu prezentacji marki.
- Wielkość próby ma znaczenie dla interpretacji odsetków. MR Generali równy 83% w Perplexity oznacza 10 z 12 odpowiedzi. Przy takiej liczebności pojedyncza odpowiedź zmienia wynik znacznie mocniej niż w pozostałych modelach.
- Rankomat.pl jest wspólnym punktem odniesienia w źródłach wszystkich pięciu systemów. W ChatGPT dzieli pierwsze miejsce z warta.pl i otomoto.pl. Wysoka liczba cytowań wskazuje źródła do analizy, ale nie dowodzi ich wpływu na pozycję konkretnej marki.
- Pozytywny wizerunek wymaga sprawdzenia kontekstu. Rekomendacje odnoszą się do potrzeb klienta i kategorii produktu. Brak w TOP10 VS nie oznacza braku pozytywnych opisów, a samo odwołanie modelu do statystyk nie potwierdza poprawności jego oceny.
Chcesz wiedzieć, jak ChatGPT i Gemini opisują Twoją markę i co zrobić, żeby pojawiać się wyżej w odpowiedziach AI? Skontaktuj się z nami - przeprowadzimy bezpłatny audyt widoczności AI dla Twojej marki.


